
Logiciel OCR gratuit : les 7 meilleurs pour extraire le texte d’un scan (octobre 2026)
Pour la plupart des gens, le meilleur logiciel OCR gratuit est NAPS2 : libre et sans publicité, il numérise et rend les PDF cherchables dans plus de 100 langues, sous Windows, macOS et Linux. Pour une image isolée, Google Docs ou l’outil en ligne de PDF24 font l’affaire ; pour des centaines de PDF scannés, OCRmyPDF s’en charge en ligne de commande.
7 logiciels comparés · versions vérifiées le 10 octobre 2026 sur les dépôts et les sites officiels · sans lien d’affiliation
L’OCR (reconnaissance optique de caractères) convertit l’image d’un texte en un texte qu’on peut chercher, copier et modifier. D’une personne à l’autre, les besoins varient beaucoup : copier trois lignes d’une capture d’écran, rendre cherchable une facture scannée ou numériser toutes les archives d’une association. Les sept outils présentés ici sont gratuits. Ils ne servent pas au même usage, et c’est par là que commence le tableau.
Le comparatif en un tableau
| Rang | Logiciel | Idéal pour | Systèmes | Résultat | Contrepartie |
|---|---|---|---|---|---|
| 1 | NAPS2 | Numériser et rendre un PDF cherchable | Windows, macOS, Linux | PDF avec texte | Aucune (logiciel libre) |
| 2 | PDF24 | Un PDF scanné, sans installer de logiciel | Navigateur, appli Windows | PDF ou PDF/A avec texte | Publicité sur le site |
| 3 | Google Docs (via Drive) | Récupérer le texte d’une photo dans un document modifiable | Navigateur, mobile | Document Google Docs | Compte Google |
| 4 | OCRmyPDF | Traiter des lots de PDF scannés | Linux, macOS, Windows | PDF/A avec texte | Aucune (logiciel libre) |
| 5 | PowerToys Text Extractor | Copier le texte de n’importe quelle zone de l’écran | Windows | Texte dans le presse-papiers | Aucune (logiciel libre) |
| 6 | gImageReader | Une interface graphique pour Tesseract | Windows, Linux | Texte, PDF, hOCR | Aucune (logiciel libre) |
| 7 | Tesseract | Les développeurs et l’automatisation | Windows, macOS, Linux | Texte, hOCR, PDF, ALTO | Aucune (logiciel libre) |
Les 7 meilleurs logiciels OCR gratuits, un par un
1. NAPS2 : numériser et reconnaître le texte en un seul geste
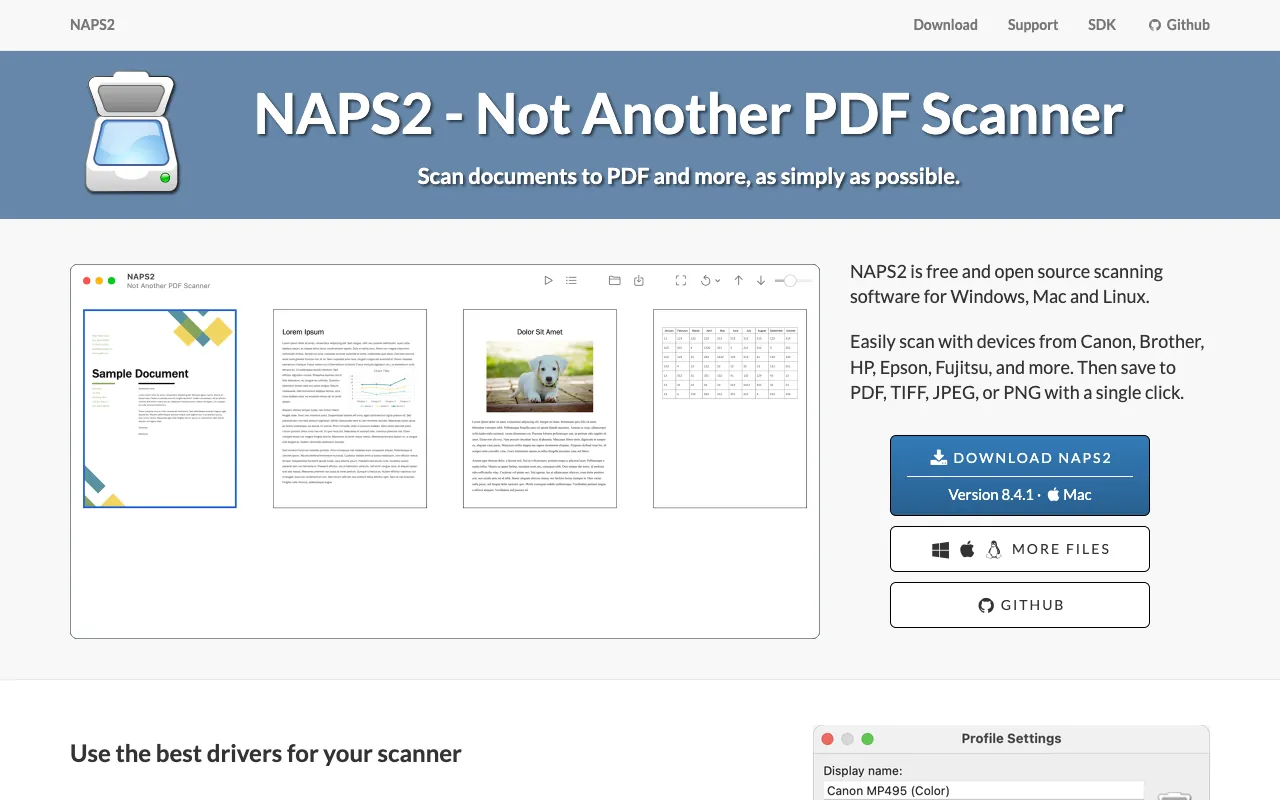
Version 8.4.1 du 3 octobre 2026 · logiciel libre · Windows, macOS, Linux · OCR dans plus de 100 langues · gratuit pour les particuliers comme pour les entreprises
NAPS2 commande votre scanner, à plat ou à chargeur, recto verso inclus, puis enregistre les pages en PDF, TIFF, JPEG ou PNG. Dès que la langue est téléchargée, chaque PDF enregistré reçoit une couche de texte invisible. Le document conserve son apparence, mais on peut y chercher un mot et en copier un passage. NAPS2 traite aussi des PDF existants : les pages qui contiennent déjà du texte restent intactes, et l’OCR passe sur les autres. Son auteur le présente comme entièrement gratuit, sans publicité ni logiciel ajouté.
- Pour qui : particuliers, associations et bureaux qui numérisent régulièrement leurs papiers.
- Limites : aucun export direct en fichier texte ; il faut passer par le PDF, puis copier le texte.
- Site officiel : naps2.com
2. PDF24 : l’OCR en ligne, ou sur PC avec PDF24 Creator
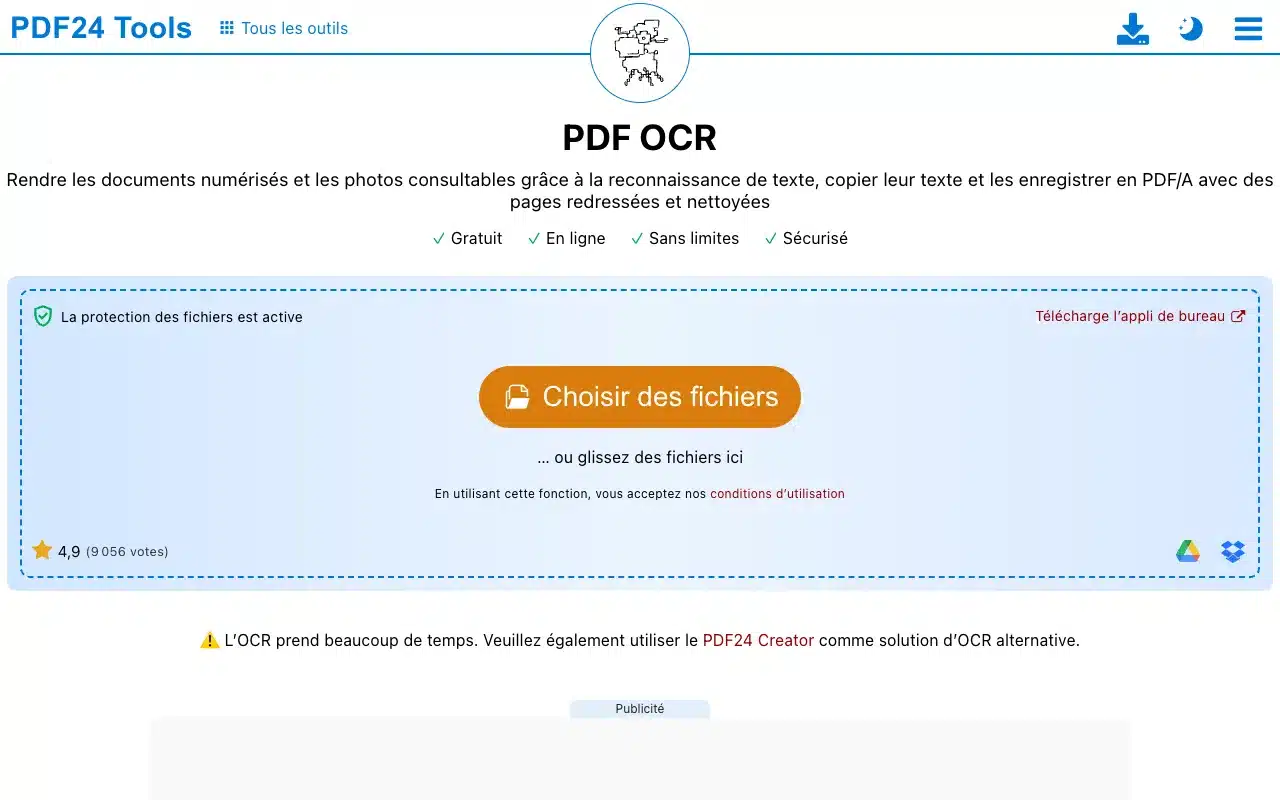
Outil en ligne « OCR PDF » présenté comme gratuit et sans limite · enregistrement en PDF/A, redressement et nettoyage des pages · application de bureau PDF24 Creator pour Windows
On dépose un PDF scanné ou une photo, on règle les options, et PDF24 renvoie un PDF dont le texte se sélectionne et se recherche. Les pages peuvent être redressées et débarrassées du bruit de numérisation, et le résultat enregistré au format d’archivage PDF/A. L’éditeur prévient que l’OCR en ligne prend du temps et propose son application PDF24 Creator, gratuite elle aussi, comme alternative sur ordinateur.
- Pour qui : un PDF scanné de temps à autre, sans rien installer.
- Limites : site financé par la publicité ; les fichiers transitent par les serveurs de l’éditeur, qui dit les supprimer peu après.
- Site officiel : tools.pdf24.org
3. Google Docs : la photo devient un document modifiable
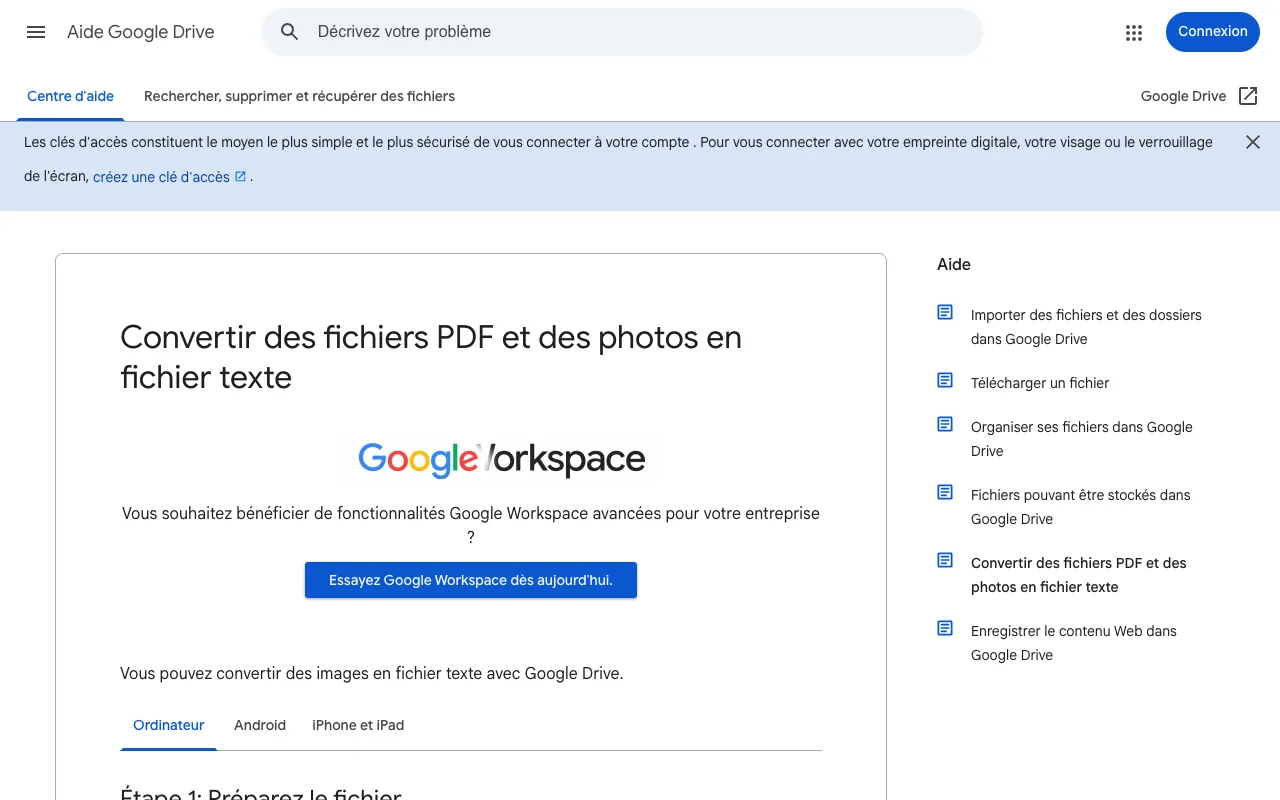
Gratuit avec un compte Google · PDF et images JPEG, PNG ou GIF · 2 Mo maximum par fichier · détection automatique de la langue
Peu de gens le savent : dans Google Drive, faire un clic droit sur une image ou un PDF puis choisir « Ouvrir avec Google Docs » déclenche une reconnaissance de texte. Le fichier est converti en document Google Docs qui contient le texte reconnu, prêt à être corrigé, copié ou téléchargé en .docx. Google recommande un texte d’au moins 10 pixels de haut, avec une image bien orientée et contrastée.
- Pour qui : récupérer le texte d’une photo de document afin de le retravailler.
- Limites : 2 Mo par fichier ; selon l’aide de Google, listes, tableaux, colonnes et notes de bas de page sont rarement reconnus.
- Aide officielle : support.google.com
4. OCRmyPDF : des centaines de PDF scannés, en une commande
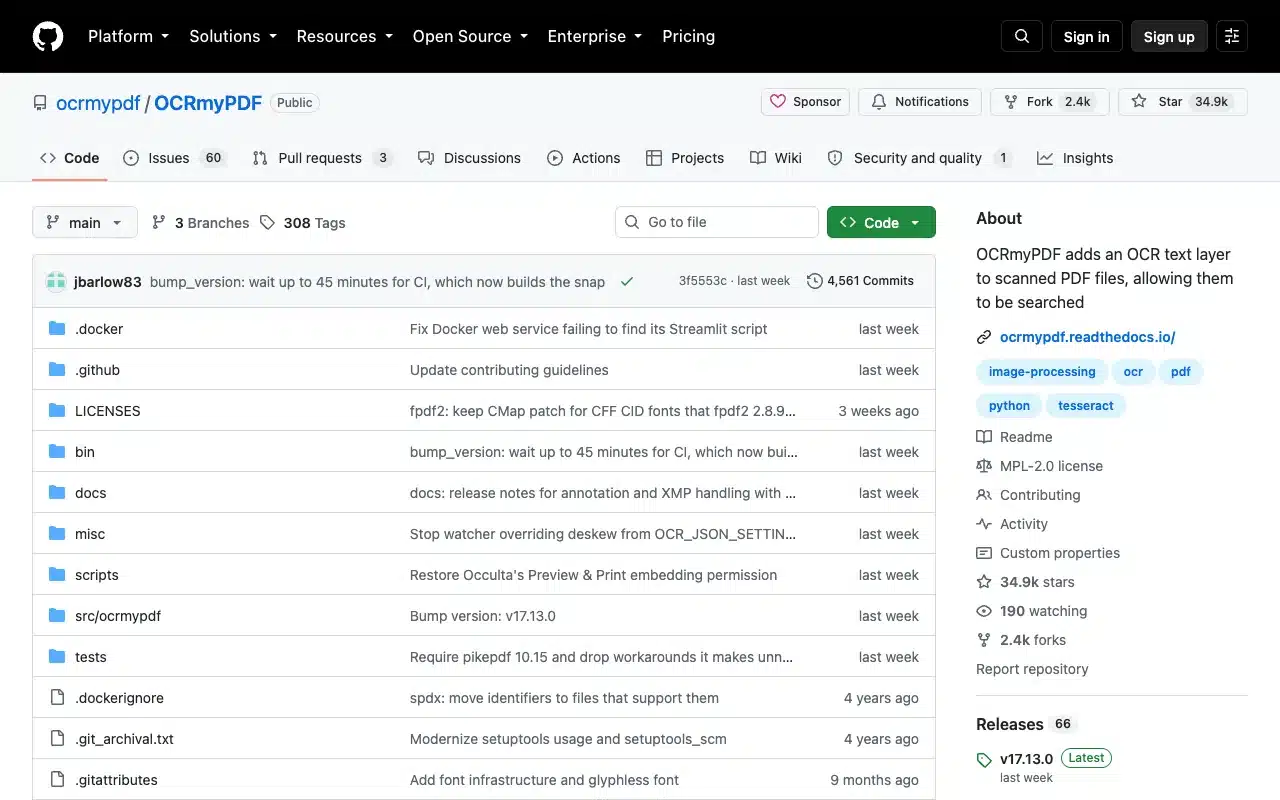
Version 17.13.0 du 28 septembre 2026 · logiciel libre sous licence MPL-2.0 · moteur Tesseract, plus de 100 langues · PDF/A par défaut
OCRmyPDF ajoute une couche de texte aux PDF scannés en conservant leur aspect, et produit par défaut des fichiers PDF/A, le format conçu pour l’archivage à long terme. Il redresse les pages de travers, répartit le travail sur tous les cœurs du processeur et s’intègre facilement dans un script ou un dossier surveillé. Il convient aux numérisations en masse et aux serveurs de gestion documentaire.
- Pour qui : les personnes à l’aise avec un terminal qui ont beaucoup de documents à traiter.
- Limites : pas d’interface graphique ; l’installation est plus simple sous Linux et macOS que sous Windows.
- Dépôt officiel : github.com/ocrmypdf/OCRmyPDF
5. PowerToys Text Extractor : copier le texte de l’écran
PowerToys version 0.101, sortie le 25 août 2026 · utilitaire libre et gratuit de Microsoft · Windows · raccourci Windows + Maj + T
Text Extractor appartient aux PowerToys, la boîte à outils gratuite que Microsoft propose pour Windows. Un raccourci clavier, on encadre une zone de l’écran, et le texte qu’elle contient est envoyé dans le presse-papiers, qu’il figure dans une image, une vidéo en pause ou une fenêtre dont le contenu ne se copie pas. L’outil repose sur les modules de langue OCR de Windows.
- Pour qui : copier une adresse, une référence ou un paragraphe qui s’affiche à l’écran.
- Limites : uniquement sous Windows ; ne traite pas un document entier ; seules sont reconnues les langues dont le module OCR est installé.
- Documentation officielle : learn.microsoft.com
6. gImageReader : Tesseract avec une interface
Version 3.4.3 du 4 août 2025 · logiciel libre sous licence GPL-3.0 · Windows et Linux · interface Gtk ou Qt
gImageReader dote le moteur Tesseract d’une interface graphique : on ouvre une image ou un PDF, on sélectionne les zones à lire, on choisit la langue, et le texte reconnu apparaît à côté, avec une correction orthographique. On peut enregistrer le résultat en texte brut ou en hOCR (un format qui conserve la position de chaque mot), puis le transformer en PDF.
- Pour qui : les utilisateurs de Linux et de Windows qui cherchent la qualité de Tesseract sans passer par la ligne de commande.
- Limites : pas de version macOS ; dernière version publiée en août 2025.
- Dépôt officiel : github.com/manisandro/gImageReader
7. Tesseract : le moteur derrière la plupart des outils libres
Version 5.5.3 du 24 juillet 2026 · licence Apache 2.0 · plus de 100 langues · sorties texte, hOCR, PDF, TSV, ALTO et PAGE
Tesseract est le moteur de reconnaissance sur lequel s’appuient OCRmyPDF, gImageReader et NAPS2. Depuis la version 4, il fonctionne avec un réseau de neurones qui lit des lignes entières. Utilisé seul, il passe par la ligne de commande ou par un programme : c’est donc la brique de base des développeurs qui intègrent l’OCR à une application.
- Pour qui : développeurs et administrateurs qui automatisent la reconnaissance de texte.
- Limites : pas d’interface ; les résultats dépendent fortement de la qualité de l’image fournie.
- Dépôt officiel : github.com/tesseract-ocr/tesseract
Comment nous avons comparé
- Versions et dates vérifiées le 10 octobre 2026 sur les dépôts GitHub et les sites officiels.
- Conditions de l’usage gratuit : licence, publicité, compte exigé, limites de taille annoncées.
- Type de résultat : PDF cherchable, document modifiable ou texte copié.
- Travail possible hors connexion, sans envoyer ses documents à un service en ligne.
Nos règles générales sont détaillées sur la page méthodologie.
Bien choisir son logiciel OCR gratuit
PDF cherchable ou texte modifiable
Un PDF cherchable conserve l’image du document et y superpose un texte invisible : idéal pour archiver puis retrouver une facture. Le texte modifiable sert, lui, à reprendre le contenu dans un traitement de texte. Le premier est produit par NAPS2, PDF24 et OCRmyPDF ; le second par Google Docs et Text Extractor.
La qualité du scan compte plus que le logiciel
Numériser à 300 points par pouce, avec une page bien droite et un bon contraste, compte davantage pour la qualité de la reconnaissance que le choix de l’outil. Écritures manuscrites, tableaux et mises en page en colonnes posent encore problème à tous les logiciels gratuits. Relisez toujours le résultat.
Documents confidentiels : restez hors connexion
NAPS2, OCRmyPDF, gImageReader, Tesseract et Text Extractor fonctionnent sur votre ordinateur. Les outils en ligne, eux, envoient le fichier sur un serveur : à éviter pour une pièce d’identité ou un relevé bancaire.
Une fois le texte récupéré
Il faut souvent remettre en forme le texte reconnu. Pour le publier sur un site, voyez convertir texte et images en HTML. Si le PDF contient déjà du texte et que vous voulez un document Word, notre outil PDF en Word suffit, sans OCR. Pour archiver le PDF reconnu, convertissez-le avec PDF en PDF/A.
Questions fréquentes
Quel est le meilleur logiciel OCR gratuit ?
NAPS2 pour numériser et rendre les PDF cherchables, sous Windows, macOS et Linux. Google Docs pour une photo ponctuelle ; OCRmyPDF pour un traitement en masse.
Comment extraire le texte d’une image gratuitement ?
Importez l’image dans Google Drive, faites un clic droit, puis choisissez « Ouvrir avec Google Docs » : le fichier devient un document Google Docs qui contient le texte reconnu. Sous Windows, PowerToys Text Extractor copie le texte d’une zone de l’écran grâce à Windows + Maj + T.
Existe-t-il un OCR gratuit sans installation ?
Oui : l’outil OCR PDF de PDF24 et Google Docs tournent dans le navigateur. Ils transmettent cependant le document à leurs serveurs.
Un logiciel OCR gratuit reconnaît-il le français ?
Oui. Tesseract et les outils qui s’appuient sur lui (NAPS2, OCRmyPDF, gImageReader) reconnaissent plus de 100 langues, français compris, pourvu que la langue soit téléchargée.
L’OCR reconnaît-il l’écriture manuscrite ?
Mal, avec les outils gratuits présentés ici, pensés pour le texte imprimé. Une écriture manuscrite très lisible peut passer, mais on doit s’attendre à de nombreuses corrections.
Sources et date de relevé
- NAPS2 : site officiel, page de documentation OCR et dernière version publiée sur GitHub (8.4.1, 3 octobre 2026), consultés le 10 octobre 2026.
- PDF24 : page « OCR PDF » de tools.pdf24.org.
- Google : page d’aide Google Drive « Convertir des fichiers PDF et des photos en fichier texte ».
- OCRmyPDF : dépôt GitHub (17.13.0, 28 septembre 2026, licence MPL-2.0).
- Microsoft : documentation de PowerToys Text Extractor et dernière version parue sur GitHub (0.101, 25 août 2026).
- gImageReader : dépôt GitHub (3.4.3, 4 août 2025, licence GPL-3.0).
- Tesseract : dépôt GitHub (5.5.3, 24 juillet 2026, licence Apache 2.0).
Résumer cet article avec l’IA